


Jak ocenia się suplementy w skali siły dowodów (i jak czytać te oceny)
Hierarchia dowodów, GRADE, NNT i oceny literowe wyjaśnione na podstawie dokumentów źródłowych. Sprawdź, co naprawdę znaczy ocena przy suplemencie.
Na jednej półce apteki stoi preparat sprawdzony w kilkudziesięciu badaniach z randomizacją i taki, za którym stoi jedno doświadczenie na hodowli komórkowej. Etykiety wyglądają podobnie. Różnicę widać dopiero wtedy, gdy umiesz przeczytać, skąd pochodzi liczba i jak mocny jest projekt badania, który ją wyprodukował. Ten tekst tłumaczy pojęcia wracające w opisach suplementów najczęściej: hierarchię dowodów, różnicę między badaniem z randomizacją a obserwacyjnym, różnicę między przeglądem systematycznym a narracyjnym, cztery poziomy pewności w systemie GRADE oraz skróty NNT, NNTB i NNTH. Każde sprawdziliśmy w dokumencie, który je wprowadził, a nie w cudzym streszczeniu, i przy każdym podajemy, co dokładnie mierzy. Znajdziesz tu także dwie rzeczy, których żadna ocena nie zawiera: wielkość efektu w minutach albo w liczbie osób oraz informację o tym, kto badanie sfinansował.
KLUCZOWE INFORMACJE
• Piramida dowodów układa projekty badań od opisów przypadków i badań podstawowych na dole po badania z randomizacją na górze, ale jej autorzy proponują zdjąć przeglądy systematyczne ze szczytu i traktować je jako narzędzie do czytania dowodów (Murad i wsp., Evidence-Based Medicine, 2016).
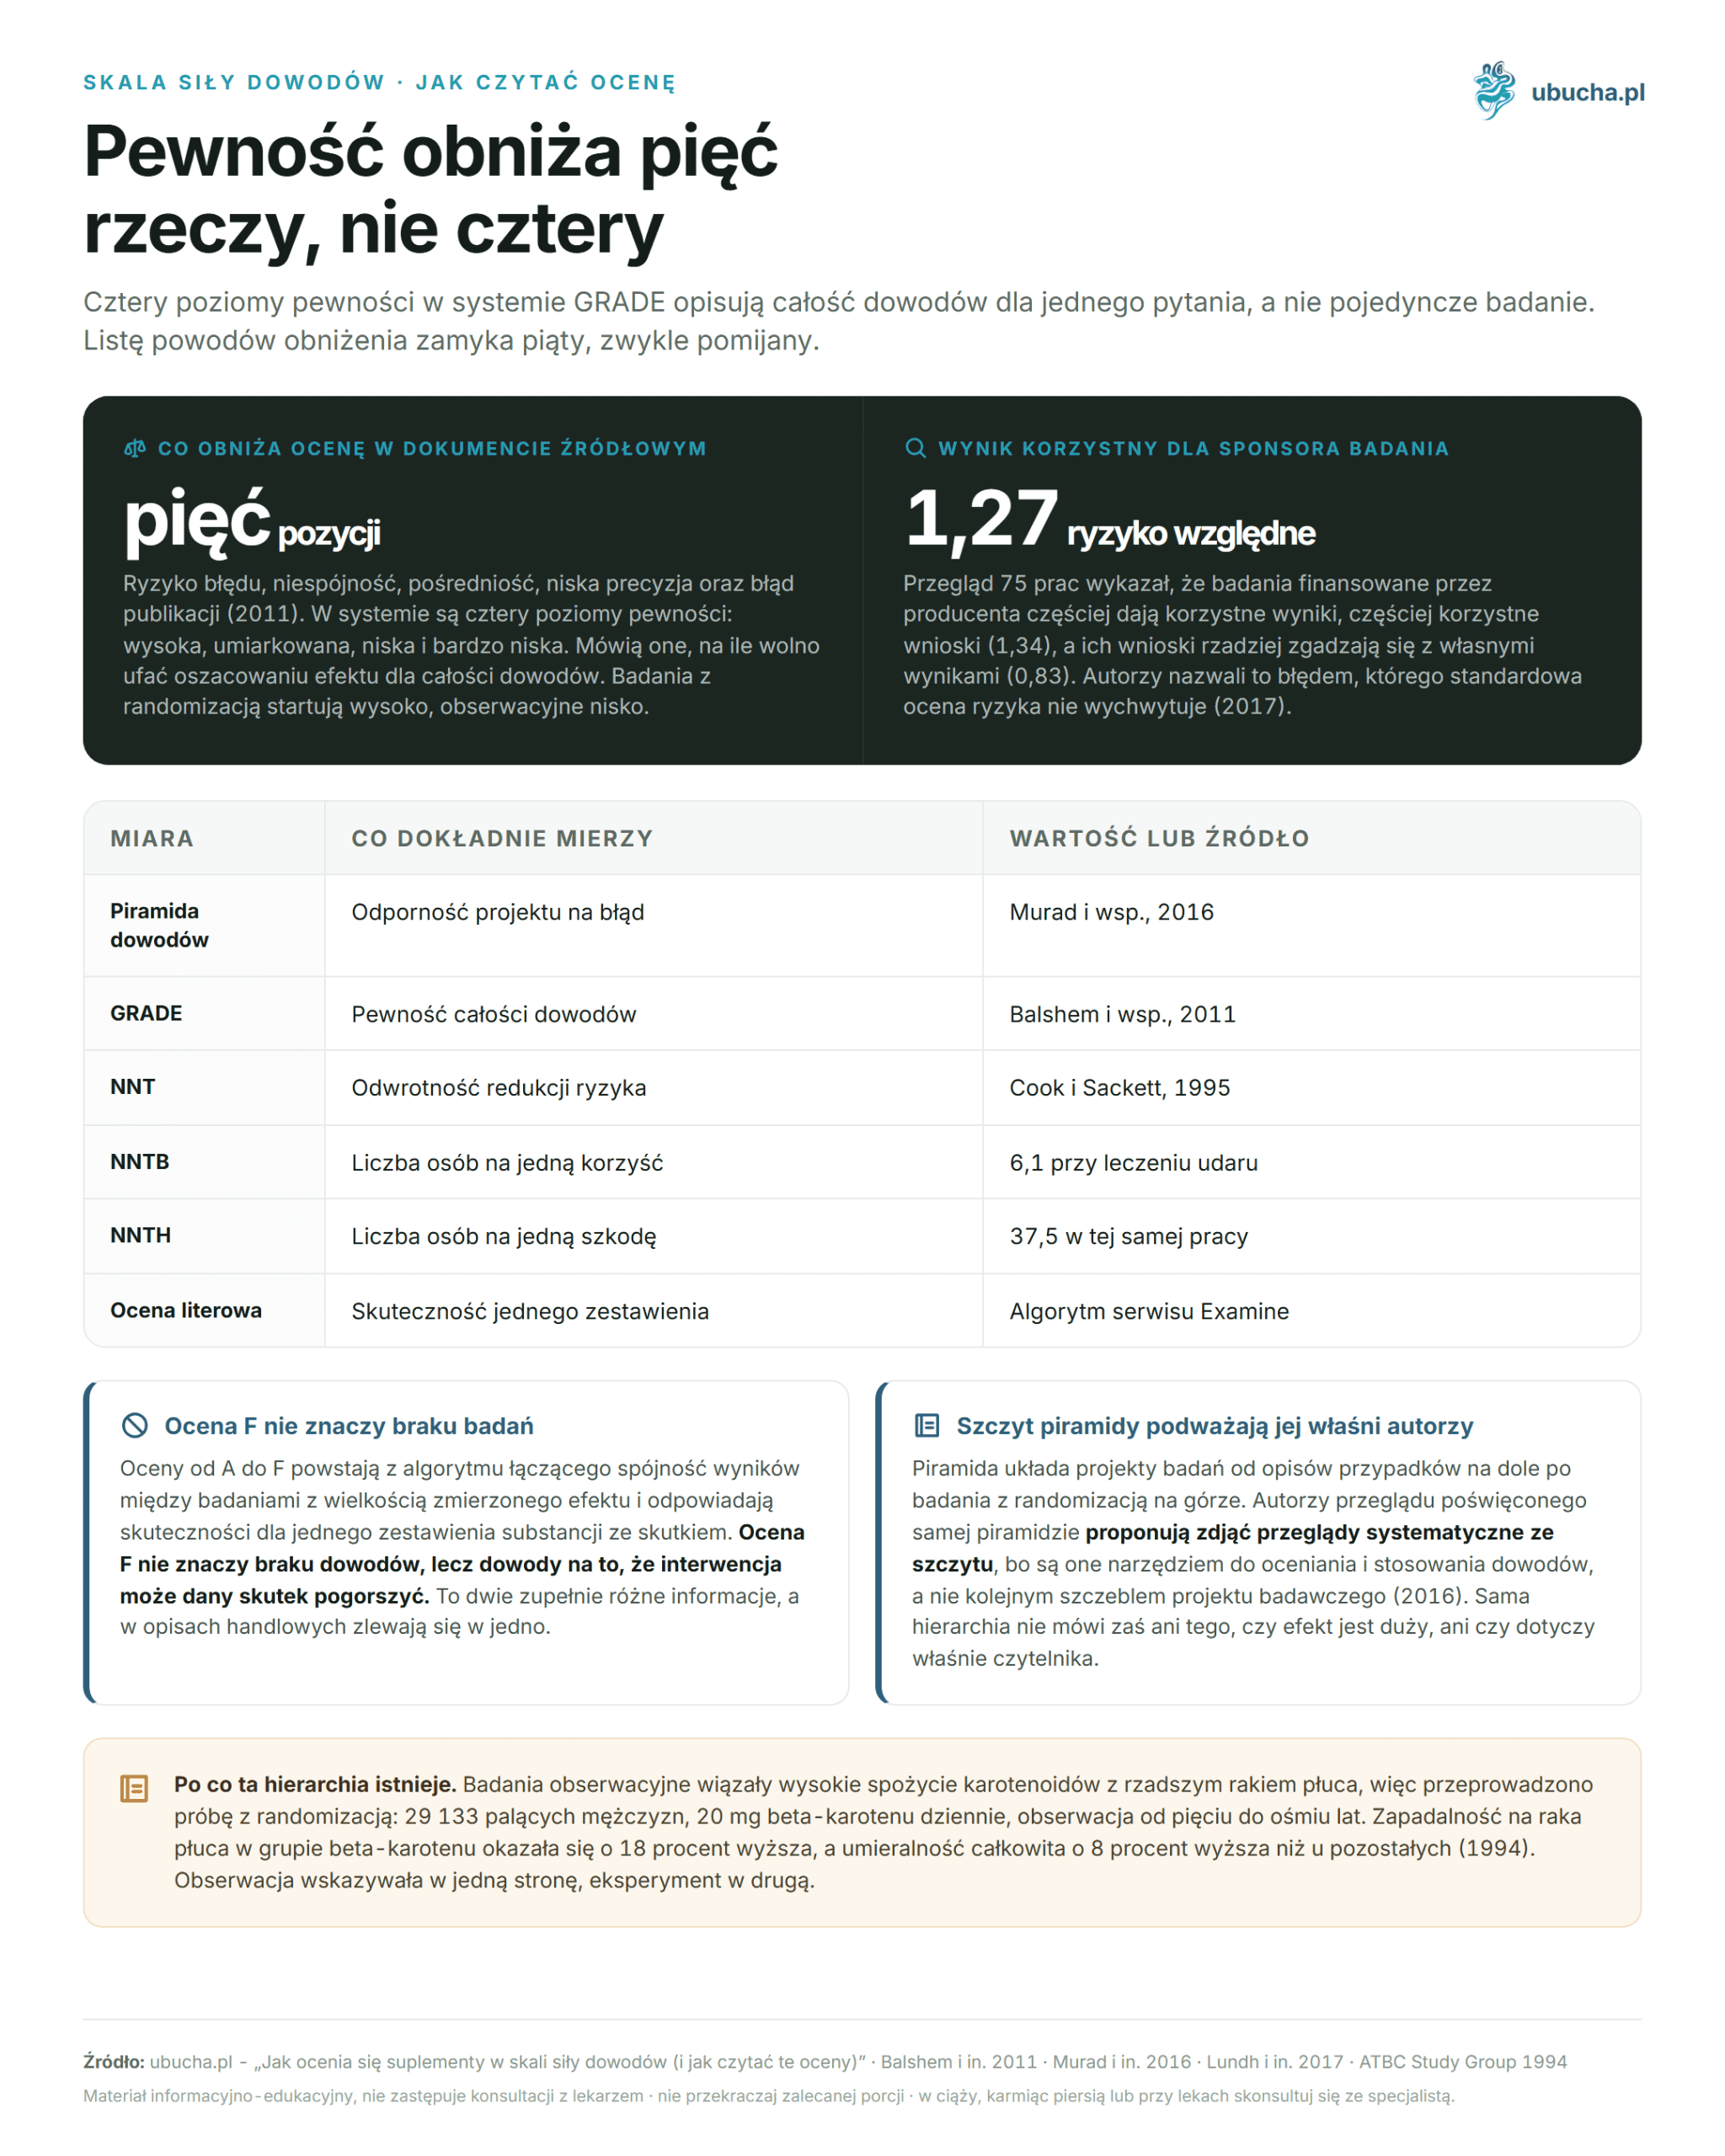
• GRADE ma cztery poziomy pewności: wysoką, umiarkowaną, niską i bardzo niską. Ocenia się nimi całość dowodów dla jednego pytania, a nie pojedyncze badanie (Balshem i wsp., J Clin Epidemiol, 2011).
• Pewność obniża pięć rzeczy, nie cztery: ryzyko błędu systematycznego, niespójność, pośredniość, niska precyzja oraz błąd publikacji.
• NNT to odwrotność bezwzględnej redukcji ryzyka. NNTB i NNTH rozdzielają tę liczbę na korzyść i na szkodę (Cook i Sackett, BMJ, 1995).
• Badania finansowane przez producenta częściej kończą się wynikiem korzystnym dla sponsora, ryzyko względne 1,27 (95% CI 1,17-1,37) w przeglądzie 75 prac (Lundh i wsp., Cochrane, 2017).
Czym jest hierarchia dowodów i czego ona nie rozstrzyga?
Hierarchia dowodów to uporządkowanie projektów badań według tego, jak dobrze każdy z nich radzi sobie z błędem systematycznym. Najczęściej rysuje się ją jako piramidę: na dole badania podstawowe i opisy przypadków, wyżej badania kliniczno-kontrolne i kohortowe, jeszcze wyżej badania z randomizacją, a na szczycie przeglądy systematyczne z metaanalizą. Autorzy przeglądu poświęconego samej piramidzie opisują ten układ, a zarazem go podważają: proponują zdjąć przeglądy systematyczne ze szczytu, bo są one narzędziem do oceniania i stosowania dowodów, a nie kolejnym szczeblem projektu badawczego (Murad i wsp., Evidence-Based Medicine, 2016).
Powód, dla którego niższe piętra są niższe, jest praktyczny. Jeśli obserwujesz osoby przyjmujące witaminę C i widzisz u nich rzadsze przeziębienia, nie wiesz, czy sprawiła to witamina, czy to, że ludzie sięgający po suplementy zwykle dbają też o sen oraz częściej trafiają do lekarza. Badanie obserwacyjne nie umie tego rozdzielić i dlatego pokazuje związek, a nie przyczynę.
Hierarchia nie rozstrzyga natomiast dwóch rzeczy, o które czytelnik pyta najczęściej. Nie mówi, czy efekt jest duży, ani czy dotyczy właśnie jego. Metaanaliza może zebrać dwadzieścia badań i wykazać efekt istotny statystycznie, który w praktyce zmienia niewiele. Ma też własne ograniczenie: niejednorodność łączonych badań, kliniczną, metodologiczną i statystyczną, da się opisać albo zmniejszyć, ale nigdy usunąć. Jak ta sama skala wygląda zastosowana do konkretnych substancji, pokazaliśmy w zestawieniu suplementów z najmocniejszymi dowodami.
Czym różni się badanie z randomizacją od obserwacyjnego?
Losowaniem przydziału. W badaniu z randomizacją uczestnicy trafiają do grupy otrzymującej preparat albo do grupy kontrolnej przez losowanie, więc obie grupy różnią się przed rozpoczęciem wyłącznie przypadkiem. Różnicę w wyniku wolno wtedy przypisać temu, co dostały. W badaniu obserwacyjnym o przydziale decydują sami uczestnicy, a wtedy razem z suplementem do jednej grupy wchodzą wszystkie cechy, które skłoniły ludzi po niego sięgnąć. Zaślepienie po obu stronach dokłada drugą warstwę: ani uczestnik, ani osoba mierząca wynik nie wie, kto co dostał.
Najkosztowniejszy przykład tej różnicy w historii suplementacji dotyczy beta-karotenu. Badania obserwacyjne wiązały wysokie spożycie karotenoidów z rzadszym rakiem płuca, więc przeprowadzono próbę z randomizacją: 29 133 palących mężczyzn z Finlandii, 20 mg beta-karotenu dziennie, obserwacja od pięciu do ośmiu lat. Zapadalność na raka płuca w grupie beta-karotenu okazała się o 18 procent wyższa (95% CI od 3 do 36 procent), a umieralność całkowita o 8 procent wyższa (95% CI od 1 do 16 procent) niż u pozostałych (ATBC Study Group, N Engl J Med, 1994). Korelacja wskazywała w jedną stronę, eksperyment w drugą.
Poniższa tabela zestawia trzy projekty razem z tym, czego każdy z nich nie potrafi rozstrzygnąć.
| Projekt badania | Co kontroluje | Czego nie rozstrzyga | Przykład odczytany u źródła |
|---|---|---|---|
| Przegląd systematyczny z metaanalizą | Błąd losowy pojedynczej próby; wyszukiwanie jest zadeklarowane z góry | Niejednorodności łączonych badań i jakości materiału wejściowego | Kreatyna i siła kończyn górnych: 53 badania, wielkość efektu 0,317 (95% CI 0,185-0,449), Lanhers i wsp. 2017 |
| Badanie z randomizacją | Różnice między grupami sprzed leczenia; przy zaślepieniu także oczekiwania | Czy wynik przeniesie się na inną populację i inny czas obserwacji | D-mannoza i nawroty zakażeń dróg moczowych: 308 kobiet, trzy ramiona, bez zaślepienia i bez placebo, Kranjčec i wsp. 2014 |
| Badanie obserwacyjne | Nic z powyższych; opisuje ludzi takimi, jakich zastało | Przyczynowości; różnice między grupami mogą tłumaczyć cały wynik | Karotenoidy i rak płuca: związek odwrócił się w próbie z randomizacją, ATBC 1994 |
Przegląd systematyczny, metaanaliza i przegląd narracyjny: co je dzieli?
Przegląd systematyczny to praca prowadzona według protokołu spisanego przed rozpoczęciem. Autorzy deklarują pytanie, bazy, słowa wyszukiwania, kryteria włączenia i wyłączenia oraz sposób oceny ryzyka błędu, a potem raportują, ile prac znaleźli i ile odrzucili na każdym etapie. Standard raportowania takiej pracy opisuje wytyczna PRISMA, dziś w wersji z 2021 roku (Page i wsp., BMJ, 2021). Jeśli w publikacji nie ma protokołu ani opisu wyszukiwania, nie jest to przegląd systematyczny, choćby słowo przegląd stało w tytule.
Metaanaliza to krok dalej, nie synonim. Jest statystycznym połączeniem wyników z badań zebranych w przeglądzie w jedną wspólną wartość razem z przedziałem ufności. Przegląd systematyczny może zakończyć się bez metaanalizy, gdy badania są zbyt różne, żeby je sumować, i taka decyzja jest sygnałem ostrożności, a nie brakiem.
Przegląd narracyjny nie ma żadnego z tych zabezpieczeń. Autor wybiera prace, które uzna za istotne, i opisuje je własnymi słowami. Bywa świetnym wprowadzeniem do tematu i bardzo często jest jedynym, co istnieje dla mało zbadanej substancji, ale nie daje żadnej gwarancji, że prace niewygodne dla tezy w ogóle trafiły do zestawienia. W praktyce to najczęstszy typ źródła cytowanego w opisach suplementów, podpisany po prostu słowem badania.
Co znaczą cztery poziomy pewności w systemie GRADE?
GRADE przyznaje ocenę wysoką, umiarkowaną, niską albo bardzo niską, i przyznaje ją całości dowodów zgromadzonych dla jednego pytania, a nie pojedynczej pracy. Ocena mówi, na ile wolno ufać oszacowaniu efektu. Badania z randomizacją startują na poziomie wysokim, badania obserwacyjne na niskim, a potem ocena wędruje w dół albo w górę (Balshem i wsp., J Clin Epidemiol, 2011).
Obniża ją pięć rzeczy: ryzyko błędu systematycznego w badaniach wejściowych, niespójność wyników między nimi, pośredniość danych, niska precyzja oszacowania oraz błąd publikacji. Ostatni z tej piątki wypada z poradników najczęściej, a jest osobnym punktem metodyki i doczekał się własnego opracowania w serii wytycznych GRADE. Ocenę mogą też podnieść okoliczności działające w drugą stronę, na przykład bardzo duży efekt albo zależność od dawki. Całość opisano najpierw w krótkim artykule przeglądowym (Guyatt i wsp., BMJ, 2008).
Praktyczne znaczenie tej skali jest proste. Umiarkowana pewność znaczy, że dalsze badania mogą oszacowanie przesunąć. Niska pewność znaczy, że mogą je odwrócić. Zdanie o obiecujących wynikach, którym opisy produktów zastępują ocenę, nie ma w GRADE odpowiednika i zwykle kryje pod sobą poziom najniższy. Umiarkowaną pewność w praktyce widać we wpisie o tym, co mówi Cochrane o N-acetylocysteinie: przy tej właśnie ocenie przegląd podaje liczbę potrzebną do leczenia równą osiem.
Co mówią skróty NNT, NNTB i NNTH?
NNT, czyli number needed to treat, jest odwrotnością bezwzględnej redukcji ryzyka. Odpowiada na pytanie, ile osób trzeba objąć interwencją, żeby jedna dodatkowa odniosła korzyść, której bez niej by nie było. Autorzy, którzy tę miarę spopularyzowali, argumentowali, że przekazuje ona lekarzowi znaczenie statystyczne i praktyczne naraz, czego nie robi samo ryzyko względne (Cook i Sackett, BMJ, 1995).
NNTB i NNTH to ta sama miara rozdzielona na dwa kierunki. NNTB liczy osoby na jedną dodatkową korzyść, NNTH na jedną dodatkową szkodę. Rozdzielenie ma sens tam, gdzie interwencja jednym pomaga, a innym szkodzi, i pozwala zestawić oba efekty w jednej tabeli. W analizie leczenia trombolitycznego udaru NNTB wyniósł 6,1 (95% CI 5,6-6,7), a NNTH 37,5 (95% CI 34,6-40,5), co autorzy podsumowali jako lepszy wynik u mniej więcej jednej osoby na sześć i gorszy u jednej na trzydzieści pięć (Saver i wsp., Stroke, 2009).
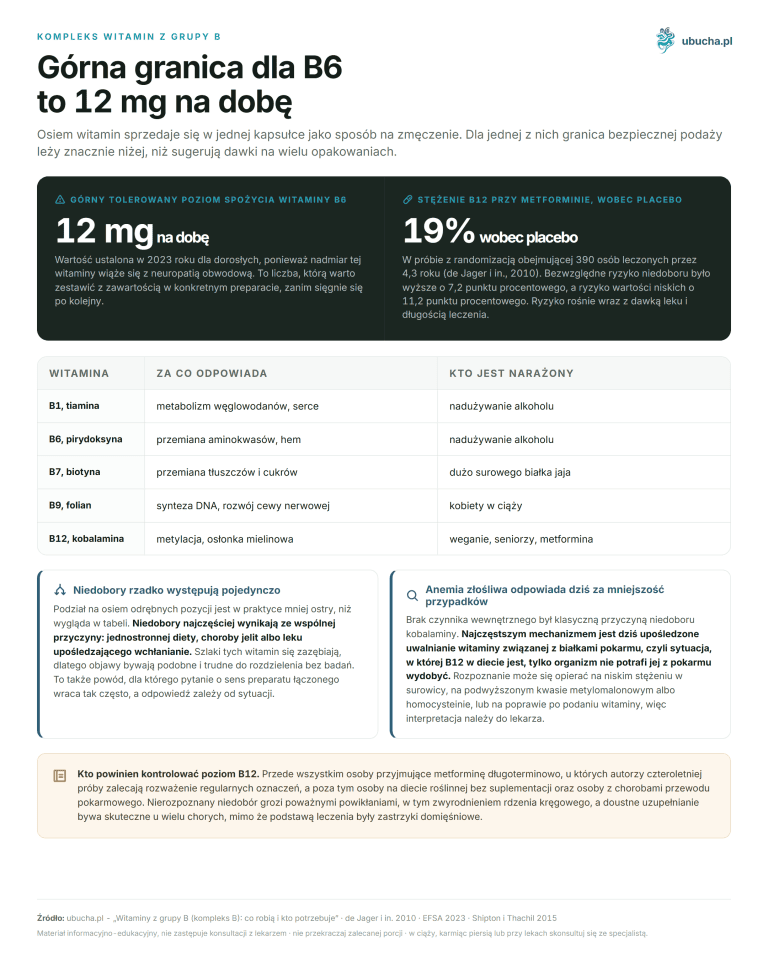
Przy suplementach te liczby pojawiają się rzadko i właśnie dlatego warto o nie pytać. Sama informacja, że różnica wobec placebo była istotna statystycznie, nie mówi, ilu ludzi musiałoby brać preparat, żeby jeden poczuł zmianę. Bez tej liczby ocena wysoka i ocena umiarkowana brzmią dla czytelnika identycznie.
Jak czytać oceny literowe i czego one nie mówią?
Serwis Examine przyznaje ocenę od A do F, osobno dla każdego zestawienia substancji ze skutkiem, więc ta sama substancja miewa A dla jednego działania i D dla innego. Wbrew rozpowszechnionemu odczytowi ocena nie mierzy samej siły dowodów. Powstaje z algorytmu łączącego spójność wyników między badaniami z wielkością zmierzonego efektu i odpowiada ogólnej skuteczności. Ocena A oznacza wiele w większości zgodnych badań wskazujących na efekt co najmniej umiarkowany, ocena D niewiele badań, wyniki rozbieżne albo efekt zerowy, a ocena F nie brak dowodów, lecz dowody na to, że interwencja może dany skutek pogorszyć.
Druga rzecz, której litera nie mówi, to znaczenie efektu dla konkretnej osoby. Metaanaliza dziewiętnastu badań na 1683 uczestnikach wykazała, że melatonina skraca czas zasypiania średnio o 7,06 minuty (95% CI od 4,37 do 9,75), wydłuża sen o 8,25 minuty i poprawia jego jakość, a autorzy sami nazwali te efekty umiarkowanymi i mniejszymi niż przy lekach nasennych (Ferracioli-Oda i wsp., PLOS ONE, 2013). Wynik jest solidny i zarazem niewielki, a te dwie rzeczy nie stoją ze sobą w sprzeczności.
Do tego dochodzi pytanie, kto badanie finansował. Przegląd metodologiczny Cochrane obejmujący 75 prac wykazał, że badania sponsorowane przez producenta częściej dają korzystne wyniki skuteczności (RR 1,27; 95% CI 1,17-1,37) i częściej kończą się korzystnym wnioskiem (RR 1,34; 95% CI 1,19-1,51), a zgodność wniosków z własnymi wynikami jest w nich niższa (RR 0,83; 95% CI 0,70-0,98). Autorzy nazwali to błędem branżowym, którego standardowa ocena ryzyka błędu nie wychwytuje (Lundh i wsp., Cochrane, 2017). Odrębnej ostrożności wymagają wyniki nazwane przez autorów eksploracyjnymi. To obliczenia, których nie zaplanowano jako głównego pytania badania, więc ważą mniej niż analiza główna, nawet gdy brzmią efektowniej. Jeśli praca sama nazywa swój wynik eksploracyjnym, a opis produktu podaje go jako ustalenie, rozjazd powstał po drodze, a nie w badaniu.
Najczęściej zadawane pytania
Czym jest hierarchia dowodów naukowych?
To uporządkowanie projektów badań według tego, jak dobrze radzą sobie z błędem systematycznym: od badań podstawowych i opisów przypadków na dole, przez badania kliniczno-kontrolne i kohortowe, po badania z randomizacją. Autorzy przeglądu o samej piramidzie proponują zdjąć ze szczytu przeglądy systematyczne i traktować je jako narzędzie do oceniania dowodów (Murad i wsp., 2016).
Czym różni się badanie z randomizacją od obserwacyjnego?
Losowaniem przydziału. Randomizacja sprawia, że grupy różnią się przed leczeniem wyłącznie przypadkiem, więc różnicę wyniku wolno przypisać badanej substancji. W badaniu obserwacyjnym o przydziale decydują sami uczestnicy, a razem z nimi wchodzą wszystkie cechy, które skłoniły ich po preparat sięgnąć. Dlatego obserwacja pokazuje związek, a nie przyczynę.
Co znaczą cztery poziomy pewności w GRADE?
Wysoka, umiarkowana, niska i bardzo niska pewność mówią, na ile wolno ufać oszacowaniu efektu dla całości dowodów o jednym pytaniu, a nie dla pojedynczej pracy. Badania z randomizacją startują wysoko, obserwacyjne nisko. Ocenę obniża pięć rzeczy: ryzyko błędu, niespójność, pośredniość, niska precyzja i błąd publikacji (Balshem i wsp., 2011).
Co znaczą skróty NNT, NNTB i NNTH?
NNT to odwrotność bezwzględnej redukcji ryzyka, czyli liczba osób objętych interwencją przypadająca na jedną dodatkową korzyść. NNTB i NNTH rozdzielają tę miarę na korzyść i na szkodę, dzięki czemu oba kierunki da się zestawić obok siebie. W analizie leczenia udaru NNTB wyniósł 6,1, a NNTH 37,5 (Saver i wsp., 2009).
Czy ocena literowa przy suplemencie mierzy siłę dowodów?
Nie tylko. Oceny od A do F w serwisie Examine powstają z algorytmu łączącego spójność wyników między badaniami z wielkością zmierzonego efektu i odpowiadają ogólnej skuteczności dla jednego zestawienia substancji ze skutkiem. Ocena F nie znaczy przy tym braku dowodów, lecz dowody na to, że interwencja może dany skutek pogorszyć.
Czy wynik badania sponsorowanego przez producenta jest wiarygodny?
Bywa, ale wymaga ostrożniejszego czytania. Przegląd Cochrane obejmujący 75 prac wykazał, że badania finansowane przez producenta częściej dają korzystne wyniki (RR 1,27) i korzystne wnioski (RR 1,34), a ich wnioski rzadziej zgadzają się z własnymi wynikami (RR 0,83). Autorzy nazwali to błędem, którego standardowa ocena ryzyka nie wychwytuje (Lundh i wsp., 2017).
Powyższe narzędzia warto zastosować, zanim kupisz cokolwiek z kategorii suplementów. Osobne zestawienie tego, gdzie dowody są najsłabsze, zebraliśmy we wpisie o tym, na które suplementy szkoda pieniędzy.
Artykuł ma charakter informacyjno-edukacyjny i nie zastępuje konsultacji z lekarzem. Jeśli jesteś w ciąży, karmisz piersią, przyjmujesz leki lub masz schorzenia przewlekłe, skonsultuj zastosowanie suplementów lub ziół ze specjalistą.
Autor: Michał Waluk · Opublikowano: 2026-08-09 · Aktualizacja: 2026-08-16